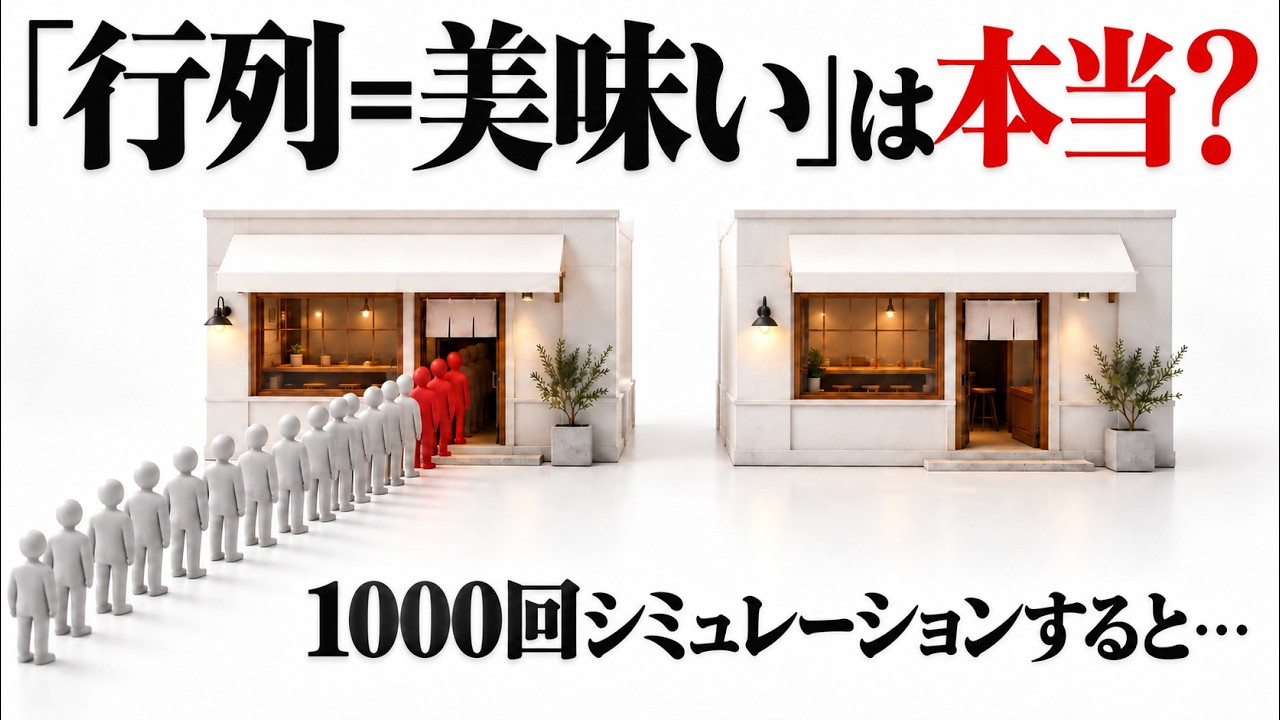
知らない町で二軒のラーメン屋が並び、片方にだけ長い行列ができている。味が全く同じでも、多くの人は行列の方に並ぶ。この現象は「情報カスケード(情報の連鎖)」と呼ばれ、初期のわずかな選択が後の大多数を引きずり込むメカニズムとして、行動経済学や社会学で繰り返し実証されてきた。本稿では、シミュレーション・理論・大規模フィールド実験の三つの視点から、なぜ行列が一度できると長く続くのかを整理し、現代のSNS評価や口コミサイトへの示唆を探る。
エージェントベースシミュレーション:味が同じでも行列が生まれる
まず、味が完全に同一な二店舗に100人の客が順番に訪れ、各自が「その日の気分(左右半々)」と「既に並んでいる人数」をわずかに重視して選ぶという最小限のルールでシミュレーションを行った。結果は以下の通りである(本稿で再現)。
- 最初の10人程度はほぼ気分通りに分散するが、その時点でどちらかがわずかに多くなると、以降の客が「人数が多い方」へ寄るため偏りが加速する。
- 100人終了時、一方の店に74人、もう一方に26人が並ぶなど、4人に3人が同じ店に集中した。
- 同じ条件で繰り返すと、どちらに行列ができるかはランダムに決まり、約6割の試行で片方が70人以上を獲得した。
- 店前の人数が見えないよう遮蔽すると、1000回試行しても70人以上の行列は一度も発生せず、ほぼ半々に分かれた。
- 最初の10人(以下「最初の10人」と呼ぶ)の配分を入れ替えるだけで、後続90人が同じ順序・同じ気分でも勝ち店が7割の確率で入れ替わった。
この単純モデルは、「行列そのものが次の行列を呼ぶ」という正のフィードバックを示しており、味の差がない場合でも大きな偏りが生じうることを数理的に裏付ける。
情報カスケード理論:バナージーらのレストラン例と初期選択の力
同様の構造を30年以上前に理論化したのが、バナージー(Abhijit Banerjee)らによる情報カスケードモデルであるBikhchandani, Hirshleifer, & Welch, 1992。二軒のレストランでガイドブック評価がわずかに左に高いにもかかわらず、99人が右の方が美味しいと聞いており、最初の1人だけが左を選ぶ設定だ。2人目は「前の人が左を選んだ=左が美味しいという私的情報を持っていた」と推論し、ガイドブックの評価と合わせて左を選ぶ。以降同じ推論が連鎖し、100人全員が左に入る。実際には右の方が美味しい確率が高かったのに、誰も合理的でない判断をしていないのに集団として誤った均衡に陥る。この「最初の数人の選択が後の全員の行動を決定づける」という構造は、シミュレーションの「最初の10人」と本質的に一致する。
実証実験:音楽市場での可視性とヒットの予測不能性
理論を現場で検証したのが、サルガニク、ワッツらによる人工文化市場実験Salganik, Dodds, & Watts, 2006である。無名バンド48曲を用意し、計14,000人以上の参加者を8つの「可視世界」(ダウンロード数が見える)と1つの「非可視世界」(見えない)にランダム割付した。主な結果は以下の通り。
- 可視世界ではヒット曲とそれ以外の格差が非可視世界より大幅に拡大した。
- 曲を人気順に並べて見せた第2実験では格差がさらに広がった。
- どの曲が1位になるかは世界ごとにバラバラで、初期のわずかな差異が最終的なヒットを決定した。
この実験は、「人気の可視化が不平等を増幅し、結果の予測不能性を高める」ことを大規模データで示した点で重要である。ただし、実験環境は音楽ダウンロードという特定文脈であり、他分野への一般化には慎重さが必要とされるSimonsohn, 2015。
コメントへの「最初の一票」が評価を歪める
より身近な場面で同様の効果を示したのが、ニュースサイトのコメント評価に対するランダム化実験Muchnik, Aral, & Taylor, 2013だ。投稿直後のコメントに研究者がこっそり「いいね」を1票加えると、その後の読者がいいねを押す確率が通常の1.3倍に上昇し、5か月後も評価が25%高いまま維持された。逆に「よくないね」を1票加えると、他の読者がいいねを押して元に戻す傾向が見られ、ネガティブな初期バイアスは自己修正されやすい一方、ポジティブなバイアスは持続しやすいことが分かった。この非対称性は、オンライン評価システムの設計において「最初の評価者の影響をどう制御するか」という実務的課題を提起する。
順位操作実験:嘘の行列が本物を作り変える
サルガニクらの同実験では、初期2,000人でランキングが形成された時点で順位を意図的に逆転させ、新たな参加者に提示したSalganik, Dodds, & Watts, 2006。真の1位曲(128ダウンロード)を9位と表示し、最下位曲を128位と表示したところ、多くの曲が嘘の順位に引きずられ順位変動した。しかし、真の1位曲だけは徐々に順位を回復し、継続すれば再び1位に返り咲く見込みだった。一方、真の2位曲は20位台から上昇できず、十分な質を持ちながら「嘘の行列」に阻まれた。さらに、順位操作世界では総ダウンロード数が約4分の1減少し、サイト自体の集客力も低下した。この結果は、「質の高いコンテンツは時間をかけて正当評価を取り戻せるが、中程度の質は初期の誤ったシグナルから脱却できず、プラットフォーム全体の価値も損なわれる」ことを示唆する。
示唆と実践的ヒント:行列を鵜呑みにしないために
以上の知見を統合すると、行列や人気ランキング、いいね数といった「社会的証明(ソーシャルプルーフ)」には以下の共通構造がある。
- 初期条件依存性:最初の数人(シミュレーションでは約10人、情報カスケードでは最初の1人)の選択がその後の大多数を規定する。
- 可視性による増幅:人数や評価が見える環境では不平等が拡大し、見えない環境では均等化する。
- 非対称な修正力:ネガティブな初期バイアスは集団によって修正されやすいが、ポジティブなバイアスは持続しやすい。
- 質の回復には時間と閾値が必要:極めて高品質なものは誤った行列を突破できるが、中程度の品質は初期の誤信号に埋もれるリスクが高い。
実践的には、以下の行動設計が考えられる。
- 行列やランキングを判断材料の一つとし、実際に体験(試食・試聴・試用)する機会を確保する。
- プラットフォーム運営側は、初期評価の表示を遅延させたり、ランダム順序で提示したりすることで「最初の10人」の影響を薄める設計を検討する。
- 消費者側は「ガラガラの店=美味しくない」と決めつけず、自分が最初の10人の一人になるつもりで新規店舗を試すことで、情報カスケードの連鎖を断ち切る一助となる。
ただし、これらの知見は主に実験室的・シミュレーション的環境で得られたものであり、現実の市場ではブランド力、立地、マーケティング、文化的文脈など多重の要因が絡み合う。したがって、行列が必ずしも味の保証ではないことは統計的傾向として理解しつつ、個別ケースでは他の情報源と併用して判断することが望ましい。専門的な意思決定(投資、医療、法務等)においては、必ず当該分野の専門家に相談されたい。
おわりに
行列のできる店がずっと行列なのは、行列そのものが次の行列を呼ぶ「情報カスケード」の連鎖と、最初のわずかな選択が運命を分ける「初期条件依存性」の二重構造にある。音楽やコメント評価でも同じメカニズムが働き、可視化された人気指標は質のシグナルとして機能しつつも、誤った均衡を生み出しうる。私たちが日常で目にする「人気」の裏側にあるこの力学を知ることは、より自律的な選択を行うための一つの知的ツールになり得るだろう。